
Duplicate Content: für SEO schädlicher doppelter Inhalt
Es gibt für Webseitenbetreiber ein häufiges Problem: doppelter Inhalt. Auf Englisch heißt dieses Phänomen Duplicate Content. Für die Suchmaschinenoptimierung können Duplikate schnell zu einem ledigen Thema werden. Bei schwacher Leistung deiner Webseite kann Duplicate Content die Ursache sein. Du weißt es aber erst sicher, wenn du die Ursache gefunden hast.
Doch, was ist Duplicate Content genau? Wie entsteht er und was kannst du dagegen machen? In diesem Ratgeber erfährst du alles Wichtige rund um das Thema.
Was ist Duplicate Content aus SEO-Sicht?
Die Definition von Duplicate Content ist gar nicht so einfach. Grundsätzlich handelt es sich um Inhalte, die komplett oder größtenteils identisch mit dem Inhalt unter einer anderen Webadresse sind. Das kann auf der gleichen Domain sein, aber auch auf einer anderen.
Allein der Begriff „identisch“ ist bei der Bewertung jedoch schon weniger eindeutig. Gilt das auch für Sidebar, Navigation und Footer? Oder geht es nur um den reinen „Contentbereich“, also meistens den speziellen Textinhalt plus Medien? Und was bedeutet „größtenteils“ identisch?
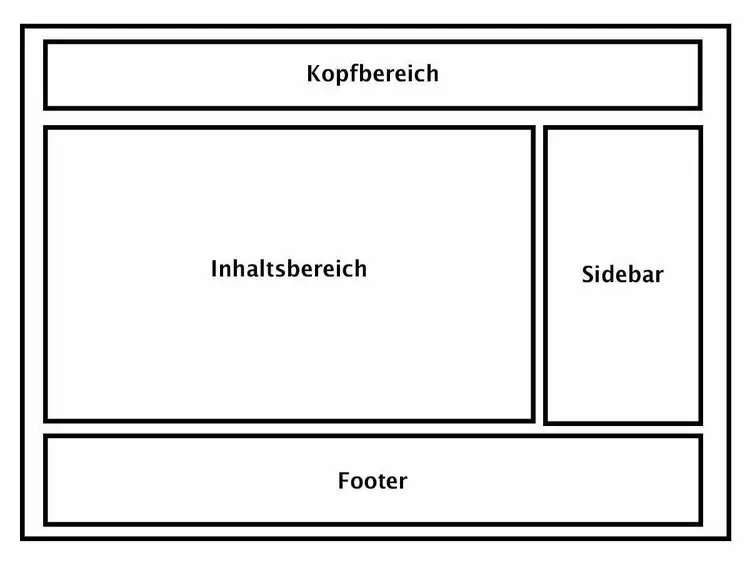
Der typische Seitenaufbau. Kurze, sich wiederholende Textpassagen in den Sektionen Kopfbereich, Sidebar und Footer sind meistens kein Problem. Identischer Content im Inhaltsbereich kann dagegen Nachteile bedeuten.
Bei reinen Kopien ist die Definition am einfachsten. 1:1-Kopien des Inhaltsbereichs gelten als doppelter Content – auch bei unterschiedlichem Text in den anderen Bereichen.
Zeigen nur die anderen Bereiche wie Sidebar und Footer die gleichen Inhalte, besteht dagegen nur eine geringe Gefahr. Nur sehr lange dort platzierte Texte können als Duplikat Probleme bereiten.
Bei der Ähnlichkeit wird es schon schwieriger. Kleine Änderungen reichen zum Beispiel nicht aus. Profis sprechen dann von „Near Duplicate Content“, also fast identische Inhalte. Selbst sinnhafte Wiederholungen können Suchmaschinen als Kopie oder „Near Duplicate Content“ ansehen. Wie viel eigenständiger Inhalt aber konkret vorhanden sein muss, bleibt leider unklar.
Einige behaupten, Kopien von bis zu 70 Prozent des Inhalts seien möglicherweise noch unproblematisch. Zumindest geben laut einigen Tests solche Seiten weiterhin Linkpower ab. Verlassen solltest du dich jedoch nicht darauf. Es ist möglich, dass Suchmaschinen schon jetzt oder in Zukunft solche Prozentsätze anders beurteilen.
Einzigartiger Inhalt und gekennzeichnete Zitate
Google betont immer wieder, dass Inhalt einzigartig sein soll. Aber: Das erlaubt durchaus Passagen, die im Wortlaut an anderen Stellen erschienen sind. Sie sollten möglichst als Zitat gekennzeichnet sein. Dennoch gilt: Es gibt keine exakte Schwelle, ab wann ein Inhalt zum Duplikat wird.
Wichtig: Tools zum Aufspüren von doppelten Inhalten nutzen leider unterschiedliche Gewichtungen. Die Inhalte sind nicht vergleichbar.
Warum reagieren Suchmaschinen empfindlich auf Duplicate Content?
Google und andere Anbieter wollen die Vielfalt des Internets abbilden und erreichbar machen. Sie haben jedoch kein Interesse, ihre Ressourcen zu verschwenden. Jeden Tag werden gigantische Mengen neuen Contents veröffentlicht. Selbst Marktführer Google kommt kaum hinterher. Jede Kopie eines anderen Artikels ist daher aus Unternehmenssicht ein Bremsklotz beim Indexieren der wirklich wichtigen Inhalte.
Finden die Suchmaschinen solche Inhalte, brauchen sie außerdem das sogenannte Crawl-Budget pro Domain auf. Die Folge: Wichtige Seiten werden gar nicht oder nur mit Verzögerung indexiert. Dieses Problem betrifft in erster Linie sehr große Seiten, kann aber alle Projekte beeinflussen.
Wie erkennt Google Duplicate Content?
Es ist nicht ganz klar, wie Google oder eine andere Suchmaschine doppelten Content erkennt. Vermutlich kommt unter anderem der sogenannte Shingle-Algorithmus zum Einsatz.
Der Shingle-Algorithmus zerlegt alle Inhalte in kleine Happen, die Schindeln. Das sind nebeneinander stehende Begriffe, wobei für jeden Begriff eine Schindel gebildet wird. Je häufiger sich die gefundenen Schindeln auf anderen Seiten wiederholen, desto wahrscheinlicher handelt es sich um ein Plagiat.
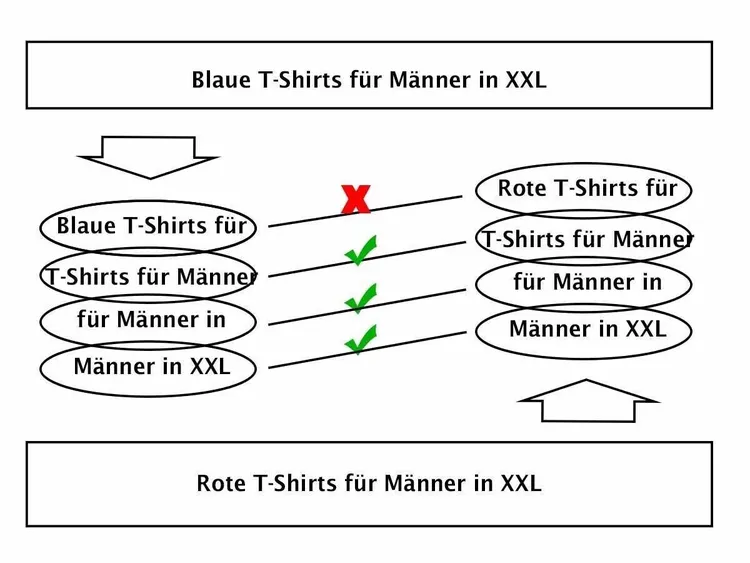
Der Shingle-Algorithmus zerlegt alle Bestandteile in Gruppen, die Shingles. Je mehr Übereinstimmungen zwischen verschiedenen Inhalten gefunden werden, desto wahrscheinlicher ist ein Duplikat
Auch eine Vorhersage-Mechanik kommt offenbar zum Einsatz. Es gibt Äußerungen, nach denen die URL dabei noch vor dem Crawlen begutachtet wird. Ist diese „duplikatverdächtig“, wird erst gar nicht gecrawlt. Die genauen Vorhersageabläufe sind aber nicht bekannt.
John Mueller von Google erläutert die Vorhersage anhand der URL-Struktur ab ca. Minute 44:00.
Wichtig zum Verständnis: Neue gecrawlte Seiten werden mit der Datenbank von Google abgeglichen. Aus diesem Grund zählt häufig die zuerst gefundene Quelle als Original. Weitere Indizien sind Themenrelevanz für das Projekt oder besonders qualitative Inhalte um das Thema herum. Auch das kann dazu führen, dass Google Kopien als Original wertet.
Negative Effekte auf Rankings und das Crawl-Budget sind möglich
Aus SEO-Sicht solltest du Duplicate Content unbedingt vermeiden. Dabei sind zwei Arten zu unterscheiden. Beide erfordern eine andere Herangehensweise und schaffen unterschiedliche Probleme.
- Externer Duplicate Content: Eine identische oder sehr ähnliche Version befindet sich auf mindestens einer weiteren Webseite. Um hier eine Lösung zu finden, muss eine der Quellen möglichst den Inhalt verändern, löschen oder deindexieren lassen.
- Interner Duplicate Content: In diesem Fall produziert die eigene Seite fast immer aus technischen Gründen doppelte Inhalte. Abhilfe schafft die korrekte Einstellung des Systems.
Es gibt laut mehrfach wiederholten Aussagen von Google-Offiziellen keine automatischen algorithmischen Abwertungen. Allerdings sind dennoch schwächere Rankings möglich, weil die jeweilige Seite durch die Dublette beeinträchtigt werden kann. Dabei sind mehrere Effekte möglich:
- Suchmaschinen werten nur eine der gefundenen Seiten als Original. Nur diese wird auf Dauer gut für den Inhalt ranken. Jede Kopie wird aber auf Dauer Plätze verlieren oder ganz aus dem Index entfernt.
- Google erkennt nicht immer das Original. Es zählt das Datum des ersten Crawls und teilweise auch die Autorität der Domains. Dadurch kann die „falsche“ Seite ranken.
- Bei internen Dopplungen wirkt der Mechanismus des Keyword-Kannibalismus. Suchmaschinen wissen nicht, welche Seite für einen Suchbegriff ranken sollen. Daher ist häufig gar keine gute platziert oder es wird die falsche Seite angezeigt.
- Wenn die Inhalte schwach oder abgekupfert wirken, kann der Panda-Algorithmus greifen und dein Projekt an Sichtbarkeit verlieren.
- Google fasst nach eigenen Aussagen gleiche URLs mit Parametern als Einheit zusammen (zum Beispiel Produkte mit verschiedenen Größen). Kann der Crawler die Ähnlichkeit jedoch nicht als solche erkennen, geht der Gesamteinheit des Produkts möglicherweise Rankingstärke verloren.
- Je häufiger dein Projekt von Duplicate Content betroffen ist, desto eher wird zum Beispiel Google die Crawler nicht mehr so häufig auf deine Seite schicken. Der Inhalt ist „nicht interessant“ für die Suchmaschinen. Das Crawl-Budget deiner Webseite schrumpft. Neue Seiten werden später indexiert. Das führt zu Indexierungsproblemen und möglichen Umsatzrückgängen.
- Echte Strafen kann es bei „geklauten Inhalten“ geben. Das Deindexieren droht zum Beispiel dann, wenn ein ganzes Projekt wie eine Kopie anderer Webseiten erscheint.
Externer Duplicate Content als Problem
Wie oben beschrieben gibt es zwei Arten von doppeltem Inhalt. Das für dich schwieriger zu lösende Problem sind Dopplungen auf anderen Webseiten. Dieses Phänomen kann dazu führen, dass deine Seiten keine guten Rankings mehr erreichen.
Wichtig: Doppelte Inhalte auf mehreren Webseiten können bei bestimmten Themen wie Pressemitteilungen sogar erwünscht sein. Vereinzelt auftretend schafft das keine Probleme. Schwierig wird es, wenn ganze Webseiten reine Kopien sind.
Wodurch entsteht externer Duplicate Content?
Wie kommt es überhaupt dazu, dass sich der Inhalt auf verschiedenen Webseiten wiederholt? Es kommt darauf an, ob du selbst das Problem verursacht oder ein Dritter. Folgende Ursachen sind besonders häufig:
- Du übernimmst Artikelbeschreibungen von Herstellern in deinem Shop.
- Du veröffentlichst Pressemitteilungen von Agenturen oder Absendern unverändert auf deiner Webseite.
- Du bindest RSS-Feeds ganzer Artikel ein.
- Du veröffentlichst einen Text, der sich nur sehr geringfügig von der Quelle unterscheidet. Typisch sind umgeschriebene Wikipedia-Artikel.
- Du veröffentlichst „gespinnte“, also automatisch erstellte Inhalte oder Inhaltsvarianten. Das wertet speziell Google als minderwertigen Content.
- Du schaffst Doorway-Pages (teilweise auch lokale Landingpages), die nur für Suchmaschinen gemacht sind und keinen Mehrwert für Nutzer haben.
- Dritte kopieren einzelne deiner Inhalte. Die Suchmaschinen erkennen aber nicht, von welcher Seite das Original stammt.
- Kriminelle kopieren (scrapen) deine gesamte Webseite, um damit schnell Rankings und Einnahmen zu generieren oder Daten abzufangen.
Die Lösung ist für die ersten Punkte einfach: Verzichte auf alle Inhalte, die es auf anderen Webseiten schon gibt. Wenn du Inhalte veröffentlichst, sollten diese eigenständig und einzigartig genug sein. Sofern du Ideen aufgreifst, fasse diese in eigene Worte und verbessere den Content durch eigene Ergänzungen.
Die Lösung bei kopierten Inhalten durch Dritte ist schon schwieriger. Juristische Schritte sind eine Möglichkeit. Gescrapte Seiten (kopierte Webseiten) stammen meistens von Kriminellen, die ihre Spuren sehr gut verwischen. In solchen Fällen hast du wenig Handhabe.
Leider hat Google eine nützliche Funktion abgeschaltet: Über den Scraper-Report konntest du früher Scraping-Webseiten melden. Theoretisch ist eine Meldung möglich, wenn die fremde Seite gegen amerikanische Urheberrechte verstößt. Von Deutschland aus ist das jedoch meistens nicht sinnvoll.
Der Scraper-Report von Google ist leider nicht mehr aktiv
Wie entsteht interner Duplicate Content und welche SEO-Lösungen gibt es?
Deutlich einfacher zu lösen, sind Probleme mit doppelten Inhalten auf der eigenen Seite. Häufig sind technisch nicht optimal eingestellte Systeme die Ursache. Diese doppelten Inhalte können sich allerdings extrem gut verstecken.
Besonders schwer zu erkennen, sind technisch bedingte Probleme. Diese spürst du bei einem SEO-Check mit guten Tools wie unseren Angeboten Site Audit oder On Page SEO Checker auf.
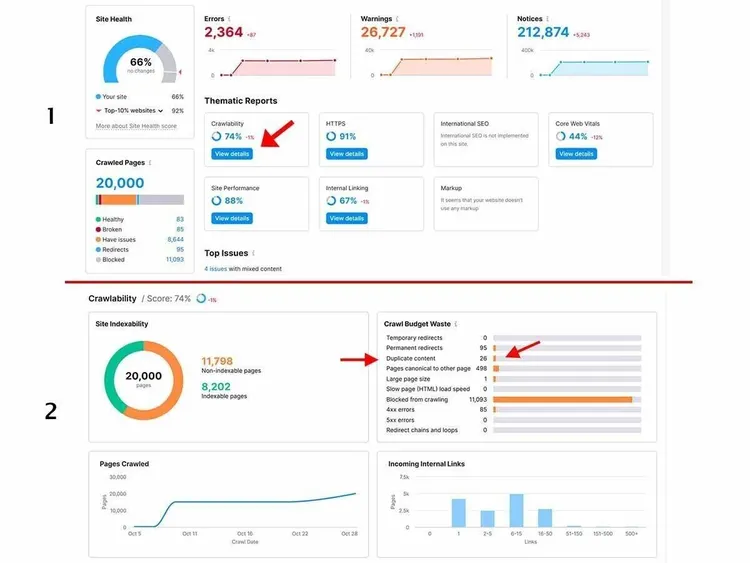
Im Rahmen eines Crawls findet unser Tool Site Audit Inhalte mit doppeltem Content. Durch Klick auf Crawlability in der Übersicht gelangst du zu einer detaillierten Infoseite. Dort findest du in der Balkengrafik den Punkt Duplicate Content. Ein Klick darauf öffnet eine Liste der betroffenen Seiten
Tipp: Wenn du von Anfang an auf eine gute Informationsarchitektur und Struktur deiner Seite achtest, entstehen viele Probleme erst gar nicht. Das gilt insbesondere für eine durchdachte URL-Struktur. Zugleich behältst du die Kontrolle über Indexierung und Gewichtung der Unterseiten.
Ursachen finden und Probleme beseitigen
Es gibt verschiedene Möglichkeiten, wie Duplikate entstehen. Häufig bemerkst du das ohne Check nicht einmal. Typische Ursache: Mehrere URLs führen auf die gleiche Seite und lassen somit per Definition Duplicate Content entstehen. Die folgende Liste gibt einen Überblick:
- Boiler-Plate-Content: Informationen in den Seitenleisten, im Kopf und im Footer-Bereich wiederholen sich auf vielen Seiten. Wenn die Informationen zu lang sind, kann das als doppelter Inhalt gewertet werden. Halte diese Inhalte kurz.
- Domain-Adresse: Ist dein Projekt sowohl ohne als auch mit www oder noch über andere Subdomains erreichbar, entsteht doppelter Inhalt. Das gilt auch für die Verbindungen über http und https. Änderungen sind durch eine 301-Weiterleitung in der .htaccess-Datei oder serverseitig auf eine der Versionen möglich. Auch die Google Search Console bietet dafür eine Einstellungsoption.
- Trailing-Slash: Sind die URLs sowohl mit als auch ohne abschließenden „/“ erreichbar, entstehen ebenfalls Dubletten. Nutze Canonical-Tags für eine der Versionen oder lege in der .htaccess-Datei eine Version als Standard fest.
- URLs mit Parameter und IDs: Große Webseiten, speziell Shopsysteme, arbeiten häufig mit Parameterzusätzen sowie IDs hinter der eigentlichen URL. Dieses Vorgehen schafft doppelten Inhalte. Für diese Inhalte sollte die Search Console genutzt werden, um Prioritäten anzuzeigen. Auch eine gute Sitemap ist hilfreich.
- Produkt-Varianten: Speziell in Shops kann es zu Problemen durch Produktvarianten kommen. Beispiel: verschiedene Farben und Größen für ein Produkt auf mehreren Seiten. Es ist besser, Varianten zu schaffen, die auf einer Produktseite per Auswahl anklickbar sind. Achte jedoch darauf, dass keine neuen Probleme durch URL-Parameter entstehen.
- Paginierung: Wenn Du auf langen Seiten oder in Kategorien eine Paginierung nutzt, solltest du diese technisch sauber umsetzen und mit einem Canonical-Tag versehen. So verstehen Crawler, welches die eigentliche Inhaltsseite ist und welches nur (weitere) Teile davon.
- Kategorien und Schlagwörter: Viele CMS und Shopsysteme nutzen Tags oder Kategorien. Klicken User darauf, öffnen sich Übersichtsseiten. Diese können je nach Einstellung ganze Seiteninhalte auflisten oder nur Teaser. Es ist ratsam, auf Teaseransicht umzustellen, um die Anzeige ganzer Seiten und damit doppelter Inhalte zu vermeiden. Aber Achtung: Fehlen eigene Beschreibungen auf den Übersichtsseiten, können auch Anrisstexte Dopplungen hervorrufen. Dann ist ein „noindex“ für diese Übersichtsseiten die beste Option.
- Funktionsseiten: Druckansichten, pdf-Formate sowie AMP-Seiten und mobile Versionen gelten ebenfalls als Duplicate Content. Du solltest für Zusatzansichten „noindex“ nutzen. AMP-Seiten und mobile Versionen sollten eine Weiche für die Crawler sowie einen passenden Canonical-Tag erhalten.
- Suchergebnisse: Zeigen Ergebnisse deiner Webseitensuchfunktion ganze Seiten an, führt das zu Duplikaten des eigentlichen Inhalts. Die Suchergebnisse sollten nur Teaser anzeigen, um das Problem zu umgehen. Zusätzlich ist es ratsam, Suchergebnisse generell auf „noindex“ zu stellen, da diese keinen eigenen Wert für Suchmaschinen haben.
- Testumgebung: Solltest du eine Staging-Seite haben, eine Testumgebung nutzen oder einfach nur dein Projekt unter einer weiteren URL weiterentwickeln, schafft das ebenfalls doppelte Inhalte. Schließe das Crawling durch „noindex“ aus. Noch besser: Setze einen Passwortschutz vor die gesamte Seite.
- Dopplungen durch Mehrsprachigkeit: Mehrsprachige Webseiten führen normalerweise nicht zu Duplicate Content. Allerdings solltest du die hreflang-Tags korrekt setzen und den gleichen Inhalt nicht über mehrere Länder-Domains zugänglich machen (zum Beispiel .de und .at oder .ch). Solange du alles auf einer Domain hast und sämtliche hreflang-Anweisungen korrekt gesetzt sind, bleiben Probleme aus.
Wie findest du Duplicate Content?
Es gibt mehrere Wege, um Duplicate Content aufzuspüren. Der beste Weg ist, bereits beim Erstellen neuer Inhalte strikt auf einzigartige Texte mit Mehrwert zu achten und so das Problem der Plagiate zu umgehen. Auch Google liefert einige Hilfestellungen.
Das schützt aber nicht vor technisch bedingten Dopplungen oder „Content-Klau“. So kannst du Duplicate Content finden:
- Nutze SEO-Checker-Tools. Unser Tool Site Audit listet dir Seiten mit doppeltem Content sowie technische Probleme auf.
- Nutze SEO Writing Assistant und prüfe deinen Content auf Originalität.
- Nutze einen Plagiatsschutz wie Copyscape. So kannst du deine Inhalte mit denen anderer Webseiten abgleichen.
- Gib kurze, prägnante Auszüge aus deinem Content bei Google ein. Die Suche liefert dir ähnliche Treffer. Dieses Vorgehen ist jedoch ungenau.
- Achte auf Indexierungsprobleme in der Google Search Console. Treten diese auf, kann Duplicate Content eine der Ursachen sein.
Fazit: Duplicate Content vermeiden!
Es ist zwar falsch, dass Google Seiten mit doppelten Inhalten bestraft. Aber es ist richtig, dass dadurch Probleme entstehen können. Daher gilt es, Unique Content zu schaffen und die Nutzerintention mit erstklassigen Inhalten zu beantworten. Zugleich solltest du dein System korrekt einstellen. Spätestens bei Indexierungsproblemen solltest du nach internem und externem Duplicate Content forschen. Denn auf Dauer schaden beide Varianten durch reduziertes Crawlen und schlechtere Rankings deiner Webseite und Suchmaschinenoptimierung.
Seit 5 Jahren verantworte ich das Marketing von Semrush in den deutschsprachigen Ländern. Seit 2010 bin ich ein leidenschaftlicher SEO. Die Kombination aus SEO und Marketing setzte ich bei großen Projekten wie die Implementierung der SEO-Maßnahmen und Marketing-Prozessen bei einem großen Retailer. Dabei betreue ich auch kleine Projekte, denn auch mal Hand anzulegen, das macht mir viel Spass. Meine Erfahrung und mein Wissen teile ich gerne mit dir.
Weist Google an, Ihnen mehr Inhalte von Semrush in den Bereichen KI, Suche und „Discover“ anzuzeigen.