
Google Bert: cosa cambia d'ora in poi
Devo ammettere, visto il mio background di linguista, che Google Bert è forse l'update di Google che ha maggiormente stimolato i miei studi al riguardo. Possiamo definirlo come una sorta di compromesso tra il web semantico e la semantica della lingua, ricordando e sottolineando che in realtà le due cose hanno poco in comune.
Come non mai questa volta ho dovuto studiare molto perché l'argomento non è per nulla semplice, anzi al contrario presenta delle enormi difficoltà di comprensione. Il problema principale è che nella maggior parte delle fonti online si trova soltanto come utilizza Google questa tecnologia, ma non cosa è in realtà questa tecnologia. Io ho provato a scavare più a fondo, spero che lo sforzo sarà a voi gradito.
Cosa vuol dire esattamente BERT?
BERT (Bidirectional Encoder Representations from Transformers) fondamentalmente è un articolo pubblicato di recente dai ricercatori di Google AI Language. Ha suscitato scalpore nella comunità di Machine Learning presentando risultati all'avanguardia su una vasta gamma di attività NLP, tra cui la risposta alle domande (SQuAD v1.1), Natural Language Inference (MNLI) e diverse altre tipologie.
La principale innovazione tecnica di BERT consiste nell'applicare la formazione bidirezionale di Transformer, un modello abbastanza noto per quanto riguarda la comprensione, alla modellazione del linguaggio. Ciò è in contrasto con gli sforzi precedenti che hanno esaminato una sequenza di testo da sinistra a destra o l’allineamento combinato da sinistra a destra e da destra a sinistra.
I risultati del documento mostrano che un modello linguistico impostato in modo bidirezionale può avere un senso più profondo del contesto e del flusso linguistico rispetto ai modelli linguistici a direzione singola.
Nel documento, i ricercatori descrivono in dettaglio una nuova tecnica chiamata Masked LM (MLM) che consente l'allineamento bidirezionale in modelli in cui era precedentemente impossibile. I suoi ricercatori hanno sviluppato alcuni processi informatici che gestiscono le parole in una frase mettendole in relazione tra loro, invece di gestirle singolarmente come avveniva finora.
Come funziona Bert?
BERT fa uso di Transformer, un meccanismo di attenzione che apprende le relazioni contestuali tra parole (o parole secondarie) in un testo. Nella sua forma originale, Transformer include due meccanismi separati: un codificatore che legge l'input di testo e un decodificatore che produce una previsione per l'attività. Poiché l'obiettivo di BERT è generare un modello di linguaggio, è necessario solo il meccanismo dell'encoder.
Il funzionamento dettagliato di Transformer è descritto in un documento di Google.
A differenza dei modelli direzionali, che leggono il testo inserito in sequenza (da sinistra a destra o da destra a sinistra), il codificatore Transformer legge l'intera sequenza di parole contemporaneamente. Pertanto è considerato bidirezionale, anche se sarebbe più esatto affermare che non è direzionale.
Questa caratteristica consente al modello di apprendere il contesto di una parola in base a tutto ciò che lo circonda (sinistra e destra della parola).
Durante l'allineamento dei modelli linguistici è difficile definire un obiettivo di previsione. Molti modelli prevedono la parola successiva in una sequenza (ad esempio: "Il bambino è tornato a casa da ___"), un approccio direzionale che limita intrinsecamente l'apprendimento del contesto. Per superare questa sfida, BERT utilizza due strategie di allenamento:
- Masked LM (MLM)
- Next Sentence Prediction
Cosa vuol dire Masked LM?
Prima di inserire una sequenze di parole all’interno di BERT, il 15% delle parole in ciascuna sequenza viene sostituita con un token [MASK]. Il modello tenta quindi di prevedere il valore originale delle parole mascherate, in base al contesto fornito dalle altre parole non mascherate nella sequenza. In termini tecnici, la previsione delle parole di output richiede:
- Aggiunta di un livello di classificazione sopra l'uscita dell'encoder.
- Moltiplicando i vettori di output per la matrice di incorporamento, trasformandoli nella dimensione del vocabolario.
- Calcolo della probabilità di ogni parola nel vocabolario con softmax.
La funzione di perdita BERT prende in considerazione solo la previsione dei valori mascherati e ignora la previsione delle parole non mascherate. Di conseguenza, il modello converge più lentamente dei modelli direzionali, una caratteristica che è compensata dalla sua maggiore consapevolezza del contesto.
In pratica, l'implementazione di BERT è leggermente più elaborata e non sostituisce tutte le parole mascherate del 15%.
Cosa è la Next Sentence Prediction?
Nel processo di allineamento BERT, il modello riceve coppie di frasi come input e impara a prevedere se la seconda frase nella coppia è la frase successiva nel documento originale. Durante l'allineamento, il 50% degli input è una coppia in cui la seconda frase è la frase successiva nel documento originale, mentre nell'altro 50% viene scelta una frase casuale dal corpus come seconda frase. Il presupposto è che la frase casuale verrà disconnessa dalla prima frase.
Come utilizzare Bert?
L'uso di BERT per un'attività specifica è relativamente semplice:
- BERT può essere utilizzato per un'ampia gamma di attività linguistiche, aggiungendo solo un piccolo livello al modello principale. Le attività di classificazione come l' analisi del sentiment vengono eseguite in modo simile alla classificazione della frase successiva, aggiungendo un livello di classificazione sopra l'output del trasformatore per il token [CLS].
- In attività di risposta alle domande (ad esempio SQuAD v1.1), il software riceve una domanda relativa a una sequenza di testo ed è necessario per contrassegnare la risposta nella sequenza. Usando BERT, un modello di domande e risposte può essere allineato imparando due vettori extra che segnano l'inizio e la fine della risposta.
- In Named Entity Recognition (NER), il software riceve una sequenza di testo che è già necessario per contrassegnare i vari tipi di entità (Persona, Organizzazione, Data, ecc.) che compaiono nel testo. Usando BERT, un modello NER può essere addestrato alimentando il vettore di output di ciascun token in un livello di classificazione che prevede l'etichetta NER.
Come lo adotta Google?
L'allineamento del modello linguistico in BERT avviene predicendo il 15% dei token nell'input, che sono stati scelti casualmente. Questi token vengono preelaborati così: l'80% viene sostituito con un token "[MASK]", il 10% con una parola casuale e il 10% utilizza la parola originale.
L'intuizione che ha portato gli autori a scegliere questo approccio è la seguente:
- Se utilizzassimo [MASK] il 100% delle volte il modello non produrrebbe necessariamente buone rappresentazioni di token per parole non mascherate. I token non mascherati erano ancora utilizzati per il contesto, ma il modello è stato ottimizzato per prevedere le parole mascherate.
- Se usassimo [MASK] il 90% delle volte e parole casuali il 10% delle volte, questo insegnerebbe al modello che la parola osservata non è mai corretta.
- Se usassimo [MASK] il 90% delle volte e mantenessimo la stessa parola il 10% delle volte, il modello potrebbe semplicemente copiare banalmente l'incorporamento non contestuale.
Cosa dice Google a proposito di Bert?
"Questi cambiamenti sono orientati al miglioramento della comprensione del linguaggio, in particolare per query più linguistiche / conversazionali, in quanto BERT è in grado di aiutare la Ricerca a comprendere meglio la sfumatura e il contesto delle parole nelle Ricerche e ad abbinare meglio quelle query con risultati utili. Soprattutto per query più lunghe e più conversazionali o ricerche in cui preposizioni come "per" e "come" contano molto per il significato, BERT sarà in grado di comprendere il contesto delle parole nella query. Il tutto rende la ricerca più naturale".
SEO e Google BERT
Bert è un approccio pre-training di elaborazione del linguaggio naturale che può essere utilizzato su un ampio corpus di testi. Gestisce attività come il riconoscimento di entità, parte del tagging vocale e la risposta a domande tra altri processi di linguaggio naturale. Bert aiuta Google a comprendere il testo in lingua naturale dal Web.
L'aggiornamento BERT di Google migliora il modo in cui Google comprende le query di ricerca.
BERT analizza le query di ricerca, non le pagine Web, quindi lato SEO diventa più importante in termini di utilizzo delle parole in modi maggiormente esatti. Il contenuto di poco valore potrebbe non essere aiutato dall'aggiornamento Google BERT.
Ricerca vocale (e BERT)
Come possiamo migliorare l'esperienza di navigazione dell'utente e la ricerca di contenuti sfruttando a nostro vantaggio la ricerca vocale? Ne abbiamo parlato nell'ultimo episodio di #SEMrushRisponde:
Esempio di una SERP pre e post BERT
Come molti addetti ai lavori riporto anch’io l’esempio di Search Engine Land:
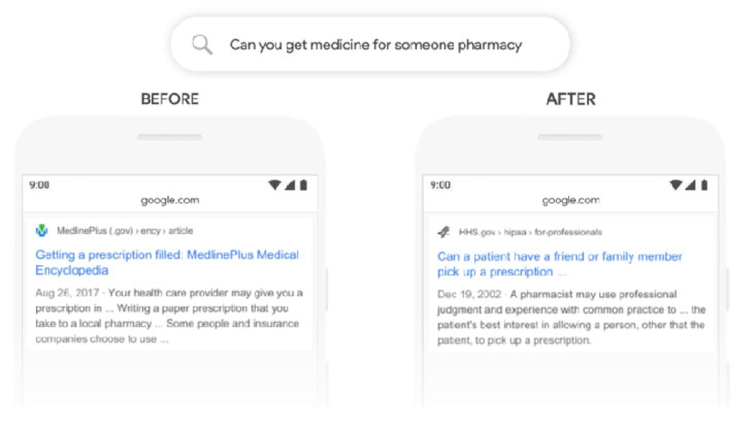
Come potrete notare il secondo risultato è molto più pertinente del primo.
Bert: cosa fare a livello tecnico?
In realtà lato SEO puramente tecnico c’è poco da fare, non cambia molto, anzi forse nulla. Dove dovrete intervenire sicuramente è sulla qualità dei vostri contenuti, che grande novità, e l’implementazione dei dati strutturati se non lo avete ancora fatto.
Per approfondire potete leggere il post: Il metodo SMR: una guida pratica alla implementazione di dati strutturati.
Vuoi saperne di più su Google Bert? Non perderti il webinar gratuito del 12 novembre!
SEMrush ha organizzato un webinar con gli esperti Ale Agostini ed Emanuele Arosio dal titolo: BERT & SEO internazionale: istruzioni per l'uso. Iscriviti subito perché si parlerà di argomenti davvero caldi come:
- la nuova semantica e NLP applicata ai risultati di ricerca
- come interpretare i contenuti multilingua in ottica SEO Internazionale, utilizzando strumenti come Market Explorer e Content Marketing Suite Tools di SEMrush
- come gestire un sito multilingua alla luce dei nuovi aggiornamenti di Google.
Che cosa ne pensi del Bert Update di Google?
Come cambierà, se cambierà, il tuo modo di lavorare d'ora in poi? Aspetto i tuoi commenti qui sotto. E per qualunque dubbio non esitare a scrivermi.
Vuoi creare contenuti SEO-friendly?
SEMrush ti aiuta con consigli pratici!
Gaetano Romeo è digital strategist, autore e docente con oltre 20 anni di esperienza in SEO, digital marketing e growth strategy. Gaetano è Head of Global Digital Marketing in EasyVista, dove integra SEO, AI e marketing automation per la crescita del business. Autore di libri su SEO e growth hacking, insegna AI e marketing in business school e università come Sole 24 Ore BS, IED e UNIMARCONI. Interviene come speaker a eventi di settore e collabora con diverse testate del panorama SEO italiano.
Chiede a Google di mostrarti altri contenuti di Semrush nelle sezioni IA, Ricerca e Scopri.