
Problemi di indicizzazione: cosa controllare e come risolverli
Il tuo sito non appare sui motori di ricerca?
Spesso quando il sito non viene trovato sul web, si pensa subito che la problematica sia dovuta al mancato posizionamento, ma in realtà potrebbe riguardare l’indicizzazione.
Si tratta di una differenza importante, che molti ancora confondono: un sito posizionato in modo errato è comunque indicizzato, quindi cercandolo sul motore di ricerca è possibile trovarlo. Un sito che non viene indicizzato, invece, è totalmente assente dall’archivio dei motori di ricerca.
In questo articolo esamineremo quali sono alcuni degli errori di indicizzazione più comuni, perché si verificano e cosa è possibile fare per risolverli. Ma prima, assicuriamoci di essere sulla stessa linea e di capire pienamente il gergo dell’indicizzazione.
Cosa sono il crawling e l’indicizzazione?
L’attività di un motore di ricerca si divide in tre macro fasi:
- SCANSIONE (crawling): il motore si avvale di uno spider, cioè un software automatizzato che scansiona tutte le pagine dei siti presenti nel web.
- INDICIZZAZIONE (indexing): le pagine scansionate dallo spider vengono valutate e aggiunte all’indice del motore di ricerca.
- POSIZIONAMENTO (ranking): con l’ausilio dell’algoritmo, il motore di ricerca esegue il rendering della pagina e, analizzando sia il contenuto testuale, che il layout visivo, decide in che posizione far apparire il sito tra i risultati di ricerca.
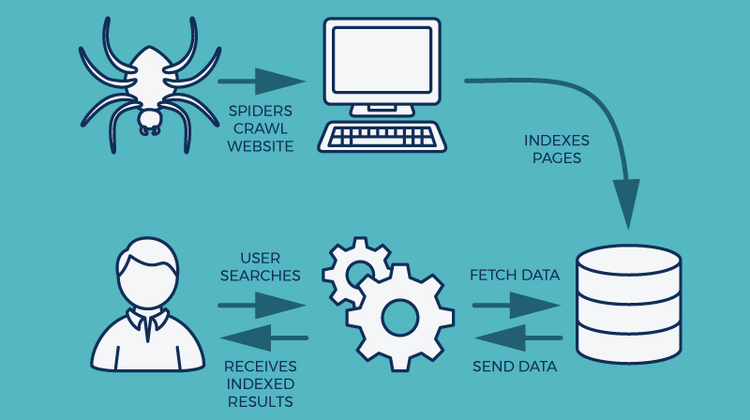
Quando un utente pone una query, chiede al motore di ricerca di restituire come risposta le pagine più pertinenti inserite nell’indice. Siccome spesso ci sono milioni di pagine pertinenti, l’algoritmo di ranking (posizionamento) fa del suo meglio per ordinare la posizione delle pagine in modo che l’utente veda per primi i risultati più rilevanti.
Questo è un video di Google che spiega il processo della ricerca nel maggiore dettaglio.
Come verificare di essere indicizzati sui motori di ricerca?
La prima da cosa da fare è capire se esiste realmente un problema tecnico nell’indicizzazione del sito. Come fare? Basta disattivare SafeSearch e digitare site:nomedominio.tld (naturalmente, cambia nomedominio.tld con il tuo dominio effettivo).
Questo ti mostrerà tutte le pagine del tuo dominio che Google ha indicizzato.
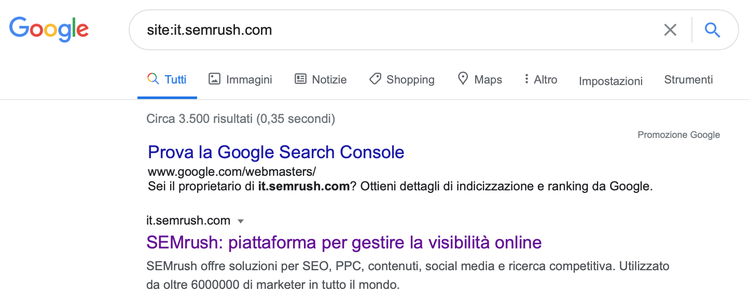
Il sito non è presente nell’indice.
Se non trovi risultati significa che il sito non è presente nell'indice.
Da quanto tempo hai pubblicato il sito? Il motore di ricerca potrebbe impiegare un po' di tempo per indicizzare le pagine! Come consiglia Google Support:
prima di supporre che ci sia un problema attendi almeno una settimana dall'invio di una Sitemap o dalla richiesta di indicizzazione.
Se il problema non è il “fattore tempo” e sei sicuro di aver implementato tutte le best practices per aiutare il motore di ricerca a trovare le tue pagine (utilizzo di URL statiche e parlanti, sistema di navigazione completo, strategia di interlinking tra le pagine principali del sito, implementazione di una sitemap.xml e invio di richiesta di indicizzazione per la home page del sito) potrebbe essere utile diagnosticare eventuali problemi di indicizzazione.
Il secondo passo, quindi, può essere quello di indagare il rapporto sulla Copertura della Google Search Console, al fine di ottenere informazioni più accurate sull’andamento del sito.
Ogni pagina può avere uno dei seguenti valori dello stato:
- Valide. Le pagine sono state indicizzate.
- Valide con avvisi. Le pagine sono state indicizzate, ma presentano un problema di cui l'utente dovrebbe essere a conoscenza. Ad esempio, le pagine bloccate nel file robots.txt sono indicate come avviso perché Google non è certo che il blocco sia intenzionale (sappiamo infatti che le direttive robots.txt non sono il modo giusto per bloccare l’indicizzazione delle pagine, ma dobbiamo usare altri metodi).
- Escluse. Le pagine non sono state indicizzate intenzionalmente.
- Errore. La pagine non sono state indicizzate perché qualcosa l’ha impedito. Queste pagine sono quelle su cui dovremmo concentrare subito la nostra attenzione. Tra gli errori più comuni: Errore 404 (Pagina non trovata).
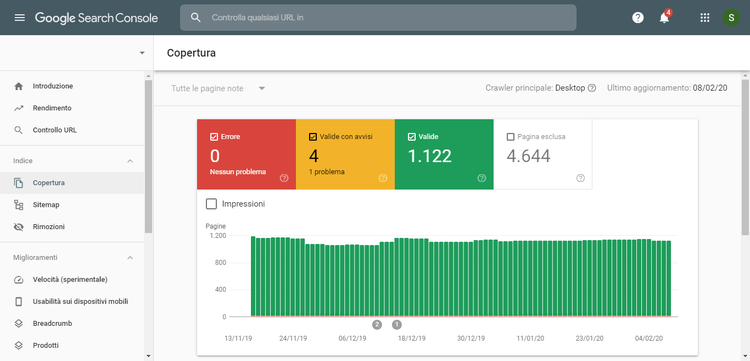
Analizza le pagine escluse dall’indice usando lo strumento Controllo URL per cercare di capire quale può essere il problema. Tra le cause più frequenti c’è il blocco della pagina tramite il file robots.txt o un’istruzione noindex.
Il sito è presente nell’indice
Se trovi un numero di risultati che non corrisponde al numero reale di pagine presenti nel sito è necessario capire quale tipo di problema compromette l’indicizzazione del sito.Il primo passo è quello di valutare l’index ratio.
Index ratio = pagine indicizzate / pagine totali del sito web
Per calcolare questo parametro:
- estrapolare il numero approssimativo di pagine indicizzate mediante il comando site o sommando le pagine valide + valide con avvisi nella sezione “Copertura” della Google Search Console
- estrapolare il numero di pagine indicizzabili, mediante una una scansione con Screaming Frog (pagine HTML canoniche che restituiscono uno status code 200 e prive di noindex + PDF)
Il rapporto perfetto è ovviamente 100% ma raramente troverai un valore così preciso:
- Valori compresi tra 90% e 110% indicano un buon rapporto
- Valori inferiori al 90% potrebbero essere sintomo di una problematica, perché significa che il motore di ricerca non sta indicizzando parecchie risorse, probabilmente per colpa di contenuti di basso valore, copiati, spam, etc.
- Valori superiori al 110% possono indicare una grave problematica. Controlla che il sito non stia indicizzando contenuti duplicati (ad esempio versione con e senza www o con e senza slash), oppure che non ci siano numerosi parametri non gestiti.
Come individuare e risolvere i problemi di indicizzazione?
1. La spunta su WordPress
Spesso accade che, quando si crea un sito web con WordPress, non si presti la massima attenzione a determinati aspetti. Il primo motivo e il più banale: una semplice spunta che scoraggia l’indicizzazione sui motori di ricerca. Anche a distanza di giorni dalla messa online del sito, questa spunta potrebbe far sparire tutti i risultati dalla SERP.
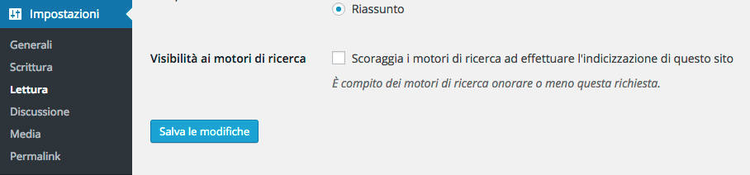
Questa è probabilmente la cosa più semplice da controllare e da correggere:1. Accedi all’area di amministrazione di WordPress e vai su Impostazioni > Lettura
2. Scorri verso il basso e individua l'opzione Visibilità dei motori di ricerca .
3. Togli il flag dalla voce “Scoraggia i motori di ricerca dall’indicizzazione di questo sito”
4. Sottoponi la home page al Controllo URL della Search Console
2. .htaccess
L’.htaccess è un file di testo editabile che risiede nella cartella WWW o public_html e permette di definire le “regole” specifiche che il sito dovrà rispettare. Può contenere configurazioni in grado di redigere il traffico verso altri domini, impostare la durata della cache, proteggere l’accesso a una cartella, impedire l’indicizzazione e molto altro.
Modificare l’.htaccess è un’azione molto delicata, che va effettuata solo dopo diverse prove in ambiente di test in quanto, commettendo errori, potremmo arrivare a scatenare un loop infinito della nostra pagina. fino ad un conseguente down del sito.
Anche se sei abbastanza esperto, il minimo assoluto da fare è scaricare una copia del file .htaccess sul tuo computer, in modo da poterlo ripristinare in caso di errore. Successivamente cerca di capire se l'errore risiede proprio in questo file e correggilo.
3. Robots.txt non configurato correttamente
Un altro passaggio che occorre effettuare per indicizzare il proprio sito web in modo corretto consiste nel controllare come sia stato inserito il file di testo robots.txt.
Il file robots.txt è un file di testo codificato con caratteri UTF-8, salvati nella directory principale (root), che contiene le direttive di accesso o di restrizione al sito, destinate ai bot dei motori di ricerca. La sintassi base di un robots.txt è abbastanza semplice: si specifica il nome di un robot e un’azione. Il crawler viene identificato dallo user agent, mentre le azioni (es. disallow) possono essere specificate nel disallow.
Generalmente il file può essere verificato digitando www.mioito.com/robots.txt.
Se c’è una riga come questa:
User-agent: * Disallow: /
Significa che state scoraggiando i motori di ricerca dalla scansione di tutto il sito.
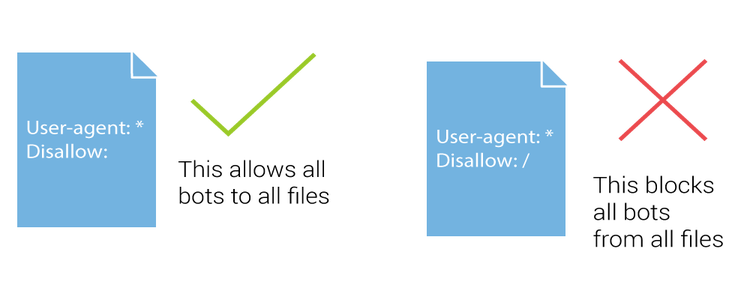
Ma, un file robots.txt configurato in modo errato potrebbe anche avere una regola che impedisce a bot e spider di eseguire la scansione di una determinata pagina che si desidera che venga visualizzata nei risultati di ricerca. Ecco un esempio:
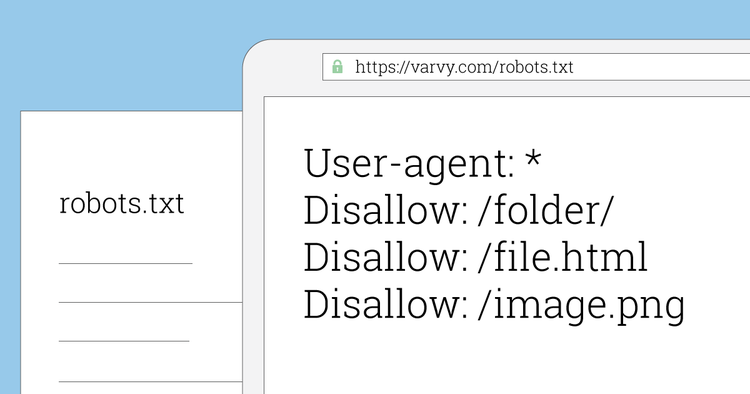
Per risolvere il problema bisogna lasciare libero il bot di ricerca di poter scansionare le pagine del sito che devono essere indicizzate e posizionate.
4. Presenza di Meta Tags che impediscono l’indicizzazione
Anche i meta tag possono fornire istruzioni agli spider su come trattare i contenuti di una determinata pagina o del sito web. La differenza rispetto al robots.txt è che vengono visualizzati sulle singole pagine e non danno una semplice istruzione a livello generale. I meta tag robots, spesso, vengono dimenticati e possono risultare insidiosi e dannosi per l’indicizzazione di un sito.Un esempio di istruzione di questo tipo: <meta name=“robots” content=“noindex”>, inserita nella sezione <head>, impedirà l’indicizzazione della pagina.Come fate a controllare se sono presenti? Quando siete sulla pagina, cliccate col tasto destro in un qualsiasi punto e selezionate “ispeziona elemento”. Vi si aprirà uno strumento attraverso cui potrete controllare la presenza della porzione di codice nella pagina.
Attenzione! I crawlers rispettano anche l’header di risposta del X‑Robots-Tag HTTP.
5. Duplicazione delle risorse
Tutti sanno che a Google piacciono i contenuti, ma il contenuto deve essere unico. Sappiamo che questa condizione è assai rara, in particolare negli e-commerce (pensate ad esempio ad una pagina di listato dei prodotti ordinati per prezzo crescente, prezzo decrescente e ultimi arrivi). Se le pagine del tuo sito web utilizzano gli stessi blocchi di contenuto, Google identifica quelle pagine come fondamentalmente le stesse, il che può comportare che Google indicizzi solo una delle pagine che visualizza il contenuto.
Di conseguenza, è opportuno indicare al motore di ricerca quale tra le pagine è quella rappresentativa, facendo in modo che diventi “canonica”, rispetto alle altre, che verranno “canonicalizzate”. Rendere “canonica” una pagina significa trasmetterle tutta l’autorevolezza acquisita nel tempo. Le altre pagine, invece, non verranno indicizzate.
<link rel =”canonical” href=”https://www.example.com/url-canonico/” />
Gli URL canonicidevono essere inseriti nella sitemap.xml.
6. Errata gestione dei parametri URL
I parametri sono porzioni di URL che seguono un punto interrogativo e specificano il percorso da compiere per raggiungere la directory nella quale è localizzata la risorsa. Generalmente vengono generati nel momento in cui l'utente seleziona uno o più attributi in una pagina di listato dell'e-commerce, ma anche quando si applica la paginazione ad un archivio del sito o si creano degli UTM per tracciare le fonti di provenienza del traffico.
Se non correttamente gestiti i parametri possono dare vita a migliaia di duplicati della pagina. Lo spider, rilevando URL differenti con lo stesso contenuto e non riuscendo a comprendere quale è la versione canonica a cui conferire più valore, potrebbe decidere di indicizzare entrambe le pagine.
Ma non solo, se gestiti in maniera errata, i parametri potrebbero causare l’esclusione degli URL dai risultati di ricerca. Ad esempio, un classico errore di questo tipo potrebbe essere la configurazione errata della funzione Gestione parametri all’interno della Google Search Console.
Nello specifico, ricorda che:
- Se il parametro è da indicizzare devi selezionare: “Si, modifica, riordina o limita i contenuti della pagina” e poi indicare la funzione del parametro (es. ordinare, circoscrivere, specificare, numerare le pagine, tradurre) e le pagine dove applicarla.
- Se il parametro non è da indicizzare devi selezionare: “No, non influisce sui contenuti della pagina”. In alternativa puoi scegliere “Si, modifica, riordina o limita i contenuti della pagina” e poi selezionare “Nessun URL”.
7. Javascript non caricato correttamente
JavaScript è un linguaggio di programmazione importante, utilizzato per creare effetti interattivi all’interno di un sito e i motori di ricerca stanno compiendo numerosi sforzi migliorare la capacità di interpretazione di queste risorse, ma restano ancora delle aree di criticità che è possibile ottimizzare.
Come funziona Javascript? Quando un utente, oppure uno spider, visitano una pagina di un sito web, il browser richiede delle informazioni al server, ovvero l’HTML base e varie risorse esterne (tra cui quelle che fanno uso di Javascript). In seguito il browser unisce tutte le informazioni acquisite per poter caricare la pagina web completa di tutte le sue caratteristiche. Quando lo spider incontra pagine web con JavaScript utilizza il proprio renderer per eseguirlo. Ma poiché questo richiede molto tempo e risorse computazionali, il rendering dei siti web basati su JavaScriptviene differito fino a quando Googlebot non dispone delle risorse disponibili per elaborare tali contenuti. Questo significa che il bot due ondate di indicizzazione tra i contenuti, ed è possibile che alcuni dettagli vadano persi.
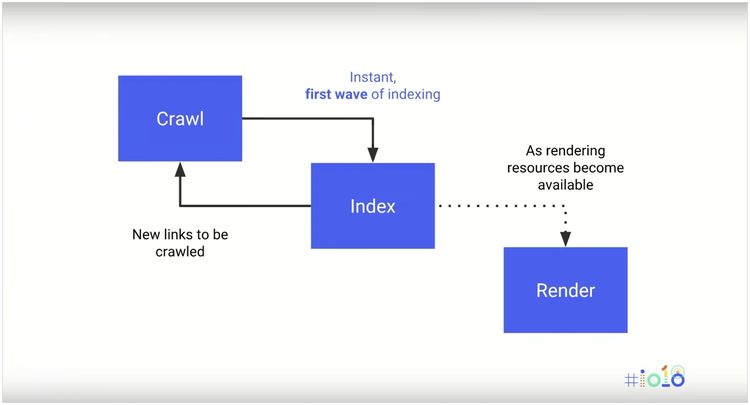
L’impostazione di JavaScript mal eseguita potrebbe provocare un’errata scansione del sito e avere così effetti negativi sull’indicizzazione e sul posizionamento del sito. Di seguito alcuni dei casi più comuni in cui un sito potrebbe avere problemi di indicizzazione:
- HTML di base troppo diversa dall’HTML finale con JavaScript. Questa tecnica viene vista in modo negativo da Google perchè in passato veniva utilizzata per mostrare una versione della pagina più ottimizzata al bot e una versione differente all’utente.
- Utilizzo massivo di Javascript. Quando Google effettua una prima scansione del sito, non ne fa anche il rendering. Questo significa che gli elementi presenti in JavaScript, ma non nell’HTML non verranno presi in considerazione dal motore di ricerca. Così facendo il sito non solo viene “recepito” in modo incompleto, ma ci sono svantaggi anche riguardo la frequenza di crawling e quindi i tempi di indicizzazione.
- Menu di navigazione, link e metadati in JavaScript. Se gli elementi fondamentali del sito sono renderizzati nella seconda ondata di indicizzazione c’è un’alta probabilità che Google non riesca a leggerli.
Prova a disattivare JavaScript dal tuo browser e naviga il sito per verificare che venga visualizzato correttamente. Puoi utilizzare una delle tante estensioni disponibili per Chrome, ad esempio “Web developer”.
Poi, confronta il codice HTML della pagina renderizzato (Google Mobile Friendly Test) con quello mostrato nel codice sorgente per evidenziare eventuali differenze.
Di seguito alcune delle principali attività che è necessario svolgere per assicurasi che il sito venga letto da Google:
- Controllare che il JavaScript non sia bloccato nel file Robots.txt
- Inserire i contenuti rilevanti lato SEO (come menu, link, testo, meta tag, immagini, video e dati strutturati) nel codice sorgente e non in JavaScript. Qualora all’interno di questi contenuti dovessero esserci delle sezioni molto pesanti, come ad esempio delle immagini, è possibile inserirle in JavaScript attraverso il lazy loading.
- Mantenere il Javascript “leggero”
8. Azioni manuali o problemi di sicurezza
Controlla se sono state applicate azioni manuali al tuo sito. Google applica un'azione manuale a un sito se un suo revisore (Quality Rater) ha stabilito che le pagine del sito non sono conformi alle norme sulla qualità per i webmaster. La conseguenza potrebbe essere un semplice calo visibile nel ranking, ma anche la rimozione totale del sito dai risultati di ricerca.
Verifica anche che non siano stati segnalati problemi di sicurezza nel sito. Se il motore di ricerca sospetta che il sito ospiti download pericolosi o contenenti spam, che coinvolga gli utenti in procedure pericolose e scorrette o che sia stato compromesso, potrebbe decidere di nascondere i risultati di ricerca all’utente.
I motivi comuni di rimozione dei contenuti dalla SERP:
- Pagine contenenti spam o di bassa qualità
- Contenuti compromessi
- Malware e software indesiderati
- Phishing/ingegneria sociale
- Rimozione per motivi legali
- Norme di Google
Se disponi dei diritti di modifica per il sito web, puoi risolvere il problema:
- Identifica il problema
- Risolvi il problema
- Richiedi un riesame
- Controlla i risultati
Per ulteriori informazioni visita il Support di Google o il sito stopbadware.org.
9. Redirect automatico sulla lingua del browser
In un sito web multilingua è possibile decidere quale versione mostrare all’utente sulla base dell’indirizzo IP o sulla lingua impostata sul client, effettuando un reindirizzamento in ragione di questi elementi. Anche se si tratta di una soluzione user friendly, la redirezione automatica potrebbe causare alcune criticità dal punto di vista SEO, infatti, questa scelta potrebbe compromettere l’indicizzazione dei contenuti.
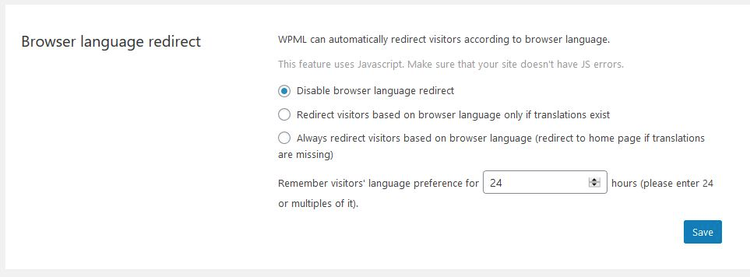
Tutte le pagine diverse dalla lingua utilizzata di default, infatti, verranno considerate duplicate, perché Google rileverà solo il canonical della lingua principale e non quello autoreferenziale, a causa del Javascript che effettua il reindirizzamento automatico e impedisce la scansione degli altri contenuti. E’ possibile capire se il sito è interessato da questo problema analizzando la Copertura della Google Search Console: solitamente aumentano le “URL duplicate e inviate, non selezionate come canoniche”.
Per risolvere il problema è necessario disabilitare il reindirizzamento in base alla lingua del browser o dell’IP ed inviare il sito alla Google Search Console per velocizzare la scansione. Non è dato sapere le tempistiche di risoluzione di questa problematica: le URL possono tornare ad indicizzarsi correttamente nel giro di un paio di giorni ma, per recuperare le posizioni perse, potranno volerci anche mesi.
10. Bug del motore di ricerca
E’ capitato più d'una volta che Google de-indicizzasse le URL per errore, per poi reinserirle dopo la segnalazione da parte dei proprietari. Perciò, se nessuna delle problematiche precedenti risponde alla problematica rilevata sul vostro sito non vi resta altro che cercare di indagare se c’è stato un bug nel motore di ricerca.
In un articolo del 12 Agosto 2019, firmato da Vincent Courson, viene spiegato in dettaglio cosa è successo a Google e come si comporta il team di sviluppo quando si verificano questi problemi. «Il più delle volte, il nostro motore di ricerca funziona correttamente» afferma Courson, «tuttavia, come tutti i sistemi complessi, a volte possono verificarsi interruzioni maggiori». Durante un aggiornamento dell’indice (ad Aprile 2019) è stata eliminata per errore una parte di documenti. Fortunatamente, gli ingegneri hanno individuato il problema abbastanza rapidamente e sono stati in grado di ripristinare l’indice di ricerca nel giro di qualche ora.
L’ultimo bug che ha interessato Google risale al 01/10/2020 ed è stato risolto nel giro di tre settimane. Quali sono stati i problemi?
- Problema dell'indicizzazione per dispositivi mobili: le nuove pagine web hanno impiegato molto tempo per essere indicizzate e apparire nell'indice di Google. Questo problema ha avuto un impatto sullo 0,2% dell’indice.
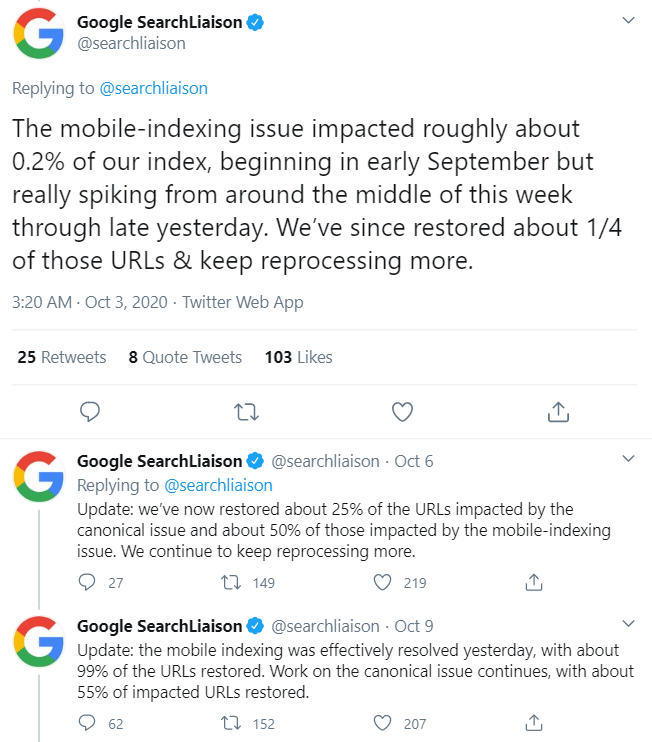
- Problema della canonicalizzazione: Google non avrebbe mostrato il contenuto originale (canonico), ma quello duplicato.
In questo caso non esistono soluzioni: non ti resta che attendere news dal motore di ricerca (a tal proposito consiglio di tenere sempre monitorato il profilo twitter di @SearchLiaison).
Trova e Risolvi i Problemi di Indicizzazione
con lo strumento Site Audit
Monica è una Senior SEO Specialist da sempre appassionata al mondo della scrittura e della cultura digitale. Al termine di un percorso di studi artistico-letterario, inizia a lavorare all'interno di una web agency di Bergamo, occupandosi di numerosi progetti di successo. Dopo quattro anni entra a far parte del team SEO della Fattoretto Agency, un’agenzia Seo & Digital PR specializzata in e-commerce. Nel tempo libero si dedica alla scrittura creativa per diversi blog di settore e partecipa come relatrice o docente alle conference italiane dedicate al web marketing. Scopri i suoi articoli!
Chiede a Google di mostrarti altri contenuti di Semrush nelle sezioni IA, Ricerca e Scopri.